腾讯实习:KV Cache 预取与卸载
软件开发实习生 · 推理基础设施·基础引擎组 · 北京
2026 年 3 月—7 月
从毕设讨论到原理性测试
毕设相关工作完成后,我和同事讨论了长上下文 LLM 推理中的 KV Cache 管理方案。团队正好有这方面的需求,于是让我牵头做原理性的测试。
测试成功后,团队决定推进实际实现。这段工作承接了毕设中的访问局部性与预取思路,进入 HY4 推理环境和 vLLM 集成后,需要面对完整 KV 数据的保存、缓存粒度和管理开销等问题。我的工作截止于 MAP 方案与确认采用 GPU;后续 SM 配置和并行阶段选择由同事负责。
我此前的工作也包括独立负责逐步局部性预取模块,以及联合设计 P/D(Prefill/Decode)分离架构下、面向 60K-token 长上下文的 GPU/Host 冷副本分存方案。
1. GPU 与 CPU 一起保存全量 KV
在这个方案里,GPU 与 CPU 内存合起来构成完整的 KV 数据集。GPU 中的数据变冷后,需要转移到 CPU 保存;后续再次需要访问的数据,再换入 GPU。
因此,缓存管理要同时处理数据换入和换出,并在这两个存储层之间保留完整 KV。这使得交换的粒度和传输量成为实现中的关键问题。
2. block 交换带来的传输放大
最初按 block 粒度交换数据。但在当时遇到的场景中,一个包含 64 个 token 的 block,实际只有 1 个 token 是这次需要的有效数据。
如果为了这个 token 交换整个 block,相对于只传所需 token,传输量就放大了约 64 倍。这个数字描述的是该场景下的传输粒度开销。
把物理传输直接改成 token 粒度,又会与 prefix cache 的 block 级统一性、复用语义和 KV 管理方式产生冲突。于是,问题变成了如何同时支持这两种粒度。
3. MAP 层:上层逻辑 block,下层物理 token
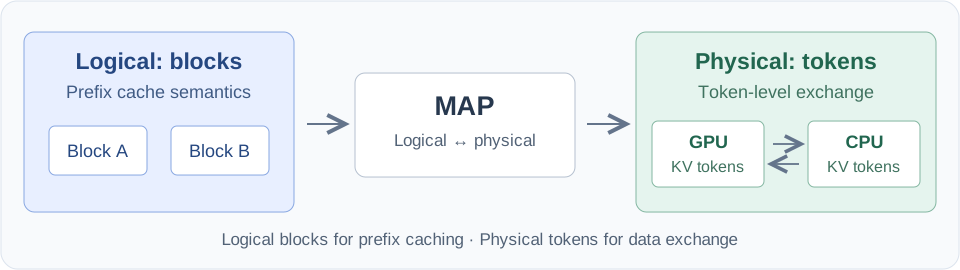
最终形成的方案是在中间新增一个 MAP 映射层,把上层的逻辑管理和下层的物理数据交换衔接起来。
- 上层保留 block 粒度。 维持 prefix cache 的逻辑语义与复用能力。
- 下层采用 token 粒度。 GPU 与 CPU 之间按实际需要的 token 交换 KV 数据,控制传输量。
- MAP 层衔接两种视图。 使逻辑上的 block 管理能够对应到物理上的 token 数据。
4. 集合成员判断、LRU 分析与带宽瓶颈
后续分析发现,缓存管理中的集合成员判断、LRU 驱逐相关分析等操作也会花费较长时间。我在排查中把主要瓶颈定位到了带宽,并比较了 CPU 与 GPU 版本。
在当时两版原型的实测中,GPU 版本明显更快,速度约差 100 倍。我的 CPU 实现当时比较粗糙,所以这里保留的是这两个具体原型的局部对比;它也成为选择 GPU 方向的依据。
这段测试帮助确认了缓存管理操作采用 GPU 的方向,我参与的工作到此为止。
团队后续:SM 配置与并行阶段选择
以下是同事负责的后续工作,作为方案发展背景记录。 团队后续发现,这部分 GPU 工作和 attention 并行时,即使只占用 1 个 SM,仍会降低 attention 的性能。
后续由同事选择把相关工作安排在 MoE 阶段,利用该工作负载中原本空余的 8 个 SM。SM 数量配置、并行阶段选择及相关后续实现均由同事负责。
这里的 8 个 SM 是该工作负载中的观察,调度方案也针对这一具体场景。
个人贡献与后续实现
我的工作包括牵头原理性测试,参与 vLLM 集成原型与方案迭代,分析 block/token 粒度冲突和缓存管理带宽瓶颈,形成 MAP 方案并确认采用 GPU。
我的工作截止于 MAP 方案与 GPU 方向确认。 后续 SM 配置、并行阶段选择,以及离职后的继续实现,均由同事负责。当前记录也没有最终生产验证结果。
与本科研究的联系
本科毕设侧重访问局部性分析、预取与驱逐策略,以及轨迹驱动模拟;腾讯实习进一步面向推理环境中的完整数据保存、缓存语义、带宽和调度约束。